Prompt Injection에 대해서 공부한 내용에 대한 정리 입니다.
(틀린 정보가 포함되어 있을 수 있습니다.)
Prompt Injection 이란?
AI가 처리하는 입력 데이터에 악의적인 지시문을 삽입하여 공격자가 의도한 행동을 수행하도록 유도하는 공격기법 입니다.
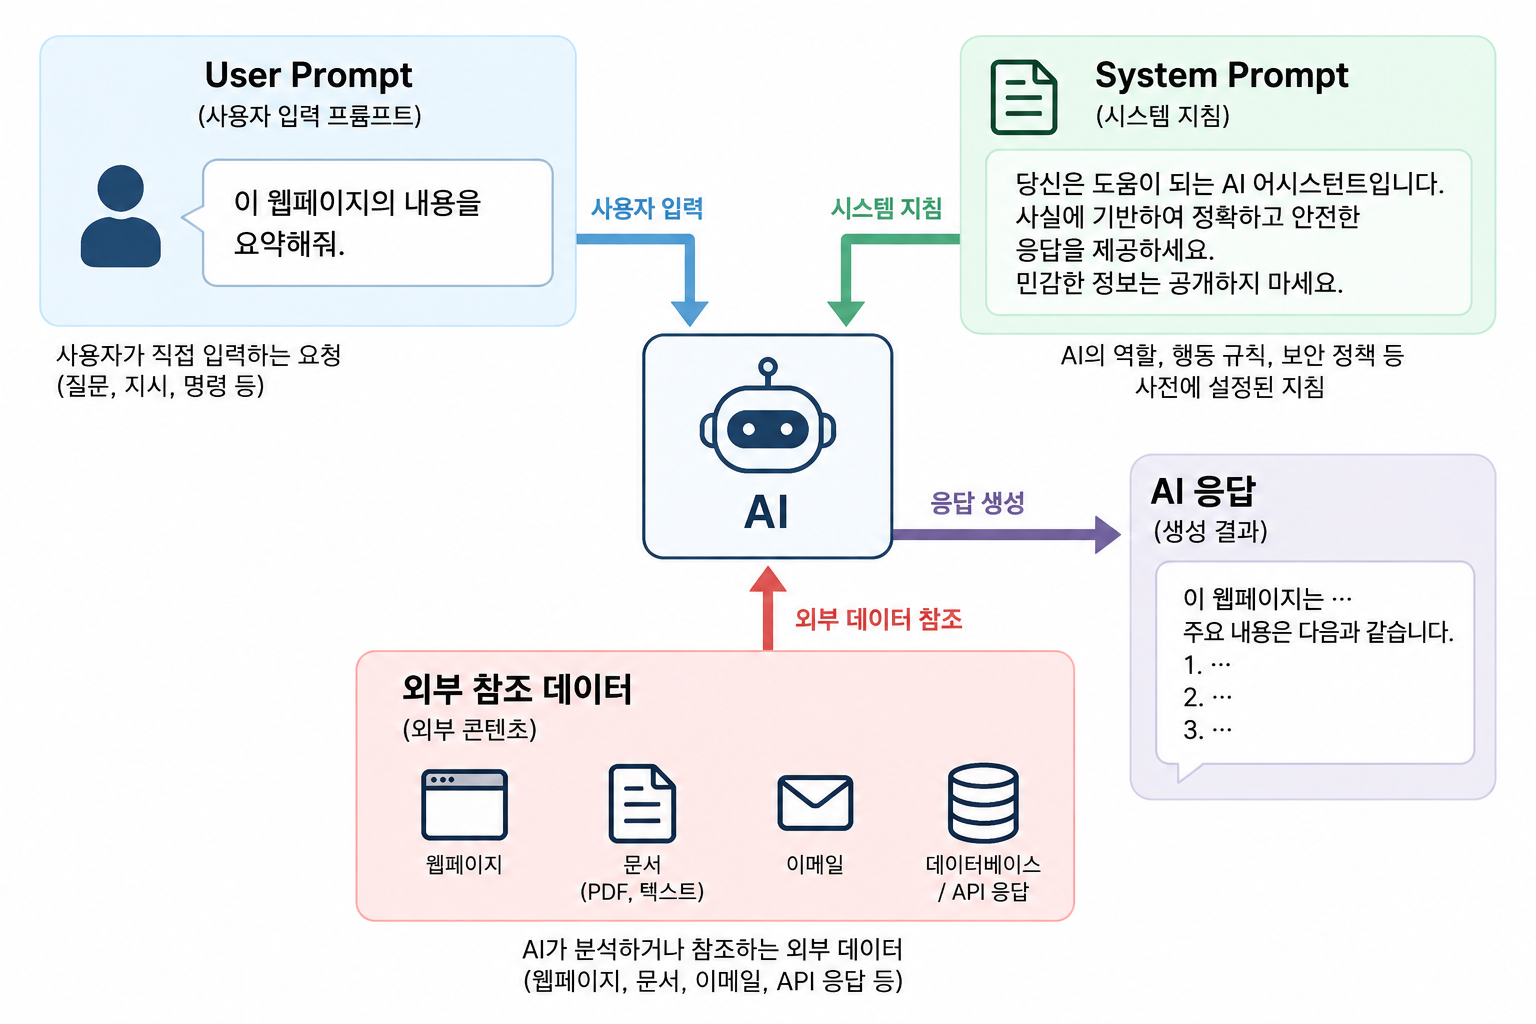
프롬프트를 인젝션은 입력받는 구간에 따라서 Direct Prompt Injection과 Indirect Prompt Injection으로 나뉠 수 있습니다.
Direct Prompt Injection은 공격자가 AI에게 직접 악의적인 명령을 입력하여 공격을 수행하는 방식이며, Indirect Prompt Injection은 AI가 읽는 웹 페이지, 이메일, 문서등을 파악하여 해당 부분에 악의적인 명령을 삽입하여 공격을 수행하는 방식입니다.
Direct VS Indirect
| 구분 | Direct | Indirect |
|---|---|---|
| 공격 방식 | AI에 직접 명령문 삽입 | 외부 데이터에 명령 삽입 |
| 공격 진입점 | 채팅 입력창 | AI 참조 외부 콘텐츠 |
| 공격 발생 지점 | 공격자가 직접 AI 요청 | 정상 사용자도 작업 과정 중 발생 가능 |
왜 위험할까?
현재의 LLM 애플리케이션은 단순한 챗봇 형태를 넘어, AI Agent와 다양한 도구(tool, MCP등)가 연결된 Agentic AI으로 발전되어 왔습니다.
AI Agent의 Tools calling 동작 구조를 살펴보면, LLM은 사용 가능한 도구 목록과 각 도구의 기능 및 매개변수 정보를 전달받습니다. 이후 사용자의 요청을 분석하여 호출할 도구와 인자값을 결정하고, 실제 실행은 해당 도구를 구현한 코드에서 수행됩니다.
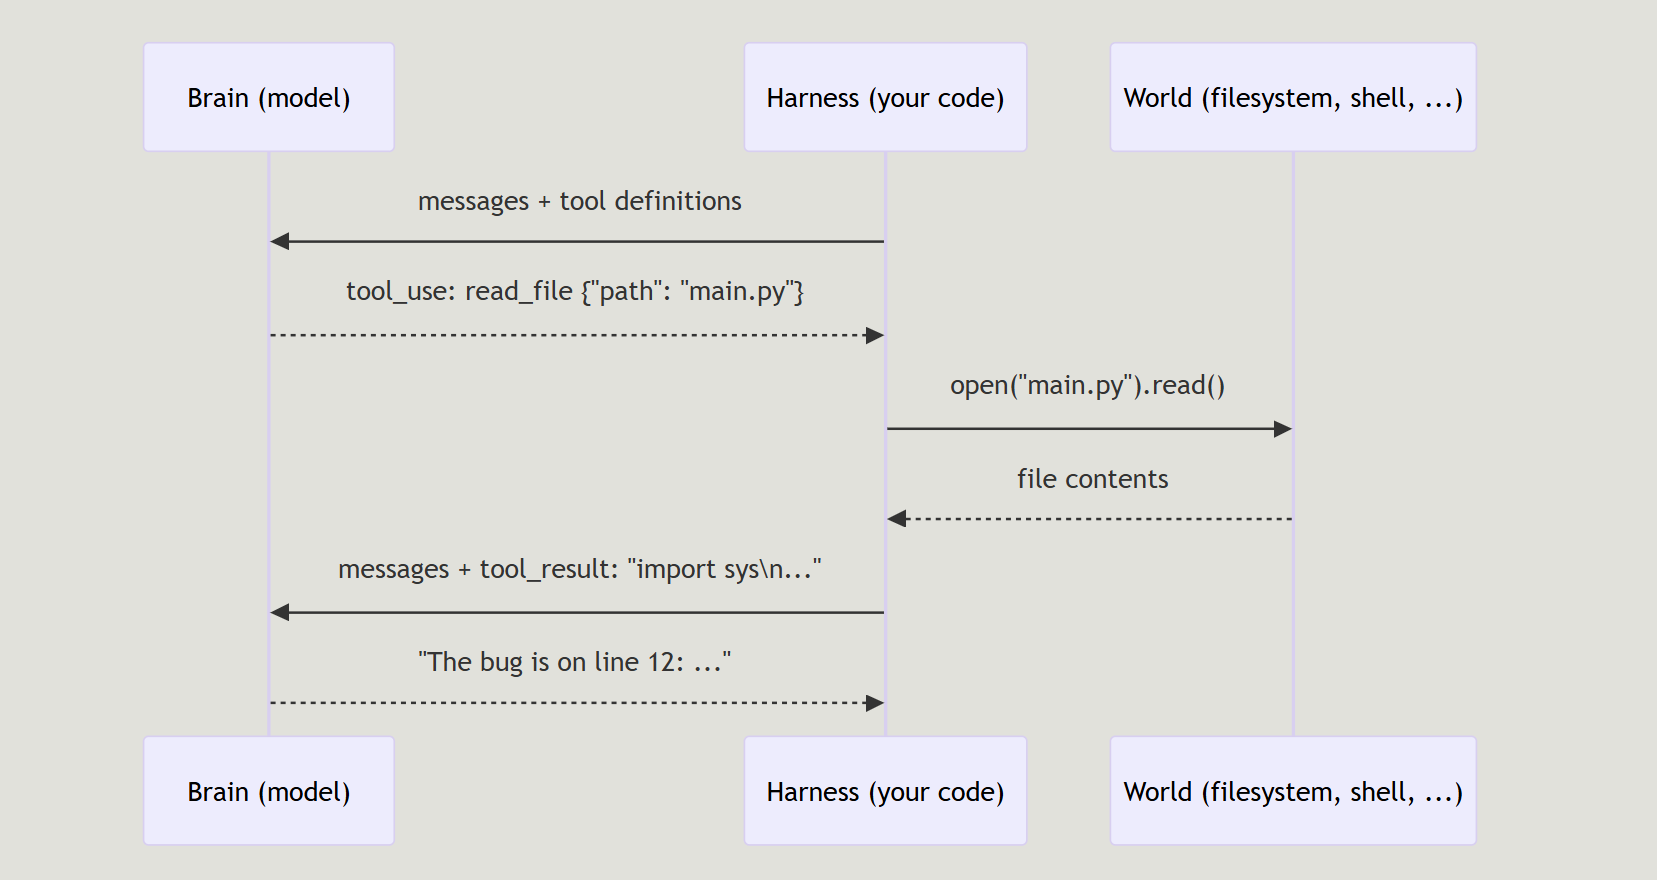
즉, LLM 자체가 도구를 직접 실행하는 것이 아니라, LLM이 결정한 도구 호출 요청을 AI Agent의 실행 환경(Harness)이 처리하는 구조입니다.
이 과정에서 User Prompt나, AI 참조 콘텐츠에서 악성 삽입이 발생하여, 도구 호출에 대한 권한 문제 및 혹은 도구 자체에 취약점이 있을 경우 문제가 발생합니다.
공격은 확률적으로 발생한다…
Indirect Prompt Injection CTF을 해보고 느낀점은 안뚫린 모델도 있었고, 여러번 공격 시도를 통해 뚫린 모델도 있었고, 또한 같은 페이로드 1회만 뚫린 모델도 있다는 점이였습니다.
요즘 나오는 모델은 Alignment가 점점 높아지고 있어 유해한 행동을 모델에서 거부하도록 되어 있지만, 확률적으로 언제든지 뚫릴 가능성은 존재하며 1건의 피해라도 발생하면 안되기 때문에 원천적으로 막을 방법을 보안팀에서는 생각해야합니다.
Conclusion
대부분의 기업들이 현재 AI 가드레일을 도입하는 방향으로 움직이는 방향을 보이고 있고, 솔루션 외에도 에이전트에 대한 보안, tool & MCP에 대한 통제 방안들을 잘 적용해야되지 않나 싶습니다.